
Статья
Как выбрать LLM/RAG-разработчика: вопросы для технического интервью
Проверяем опыт на одном сценарии: помощник по внутренним документам. Что спросить о поиске, доступах, плохих ответах и работе после релиза.
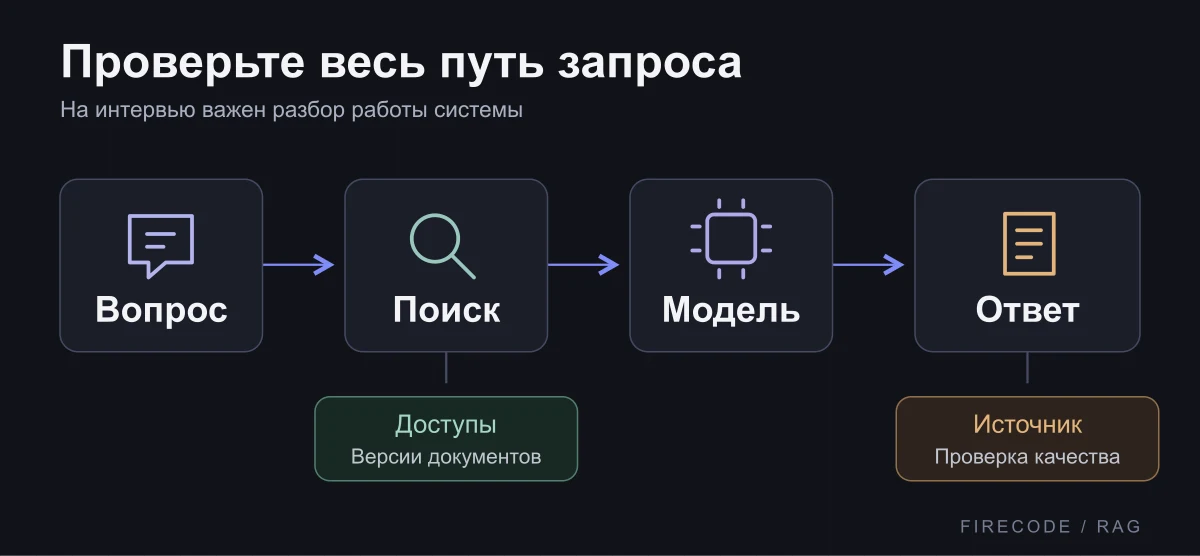
На интервью разберите путь от вопроса до ответа. Уточните, как поиск учитывает права и версии документов, откуда берётся источник и как команда проверяет качество.
Открыть схему в полном размереКандидат показывает чат с документами. Вопрос, красивый ответ, ссылка на файл. Демонстрация убедительная. Но по ней трудно понять, что случится с новым регламентом, закрытой папкой или недоступным API модели.
При выборе LLM/RAG-разработчика полезно проверить весь путь запроса: какие данные найдены, почему они выбраны, что передано модели, как проверены права и что увидит пользователь при сбое. Названия LangChain, LangGraph или векторной базы в резюме этого не объясняют.
Дайте один сценарий и меняйте условия
Для обсуждения возьмём условного помощника по внутренним регламентам. Это пример для интервью, а не клиентский кейс. Сотрудник спрашивает, как согласовать закупку, а система должна ответить по доступным ему действующим документам и дать ссылку на источник.
Не просите кандидата сразу писать приложение. Сначала пусть нарисует путь от запроса до ответа и отметит места, где возможна ошибка. Затем добавляйте условия по одному. Так легче увидеть ход мысли и отделить личный опыт от пересказа готового руководства.
В базе лежат две редакции регламента
Спросите: как в поиск попадёт актуальная версия, что произойдёт со старой и как подтвердить источник ответа? Содержательный разговор пойдёт о загрузке, метаданных, фильтрах, обновлении индекса и проверках. Если ответ сводится к «добавим в промпт просьбу использовать свежие данные», проблема остаётся.
Затем измените условие: документ удалили из исходной системы. Нужно понять, когда он исчезнет из поиска и как команда заметит, что синхронизация остановилась. Это задача на стыке разработки и инженерии данных; кандидат должен уметь обозначить эту границу.
У двух сотрудников разные права
Попросите объяснить, где проверяется доступ и может ли закрытый фрагмент вообще попасть в контекст модели. Фраза «бот не покажет секретное, мы попросим его в инструкции» не заменяет контроль доступа в приложении.
Обсудите также логи: вопрос пользователя, найденные фрагменты и ответ могут содержать конфиденциальные сведения. Что сохраняется, кому доступно и когда удаляется? Здесь хорошим признаком будет уточнение ваших требований и участие ответственного за безопасность. Обещание полной защищённости без разбора системы мало что говорит об опыте.
Поиск ничего подходящего не нашёл
Пусть кандидат предложит поведение приложения: уточняющий вопрос, сообщение о недостатке данных или передача человеку. Нужен не один универсальный вариант, а связь с задачей пользователя. Для справки по регламенту выдуманный уверенный ответ может быть хуже явного отказа.
RAG добавляет к обращению в модель найденный внешний контекст. Базовая схема есть в документации по retrieval. Ни эта схема, ни выбранная библиотека сами по себе не гарантируют достоверность ответа. На интервью проверяйте, как кандидат собирается её оценивать.
Попросите разобрать плохой ответ
Возьмите один вопрос, на котором помощник ошибся, и попросите назвать порядок проверки. Например: был ли нужный документ в источнике, загрузился ли он, попал ли в результаты поиска, передан ли модели, правильно ли использован в ответе. Это разные причины, и менять промпт при сломанной загрузке бесполезно.
Затем спросите, какие данные позволят повторить разбор после релиза. В зависимости от системы понадобятся версии модели и настроек, результат поиска, этапы запроса, задержка и ошибки. Для наблюдения за LLM-приложениями существуют инструменты трассировки: например, MLflow Tracing собирает входы, выходы и метаданные промежуточных шагов. Какие из них допустимо хранить, определяют отдельно.
Ответ «будем смотреть логи» стоит раскрыть: кто смотрит, по какому сигналу, что именно там видно и как исключить избыточную запись чувствительных данных.
Как проверить качество без показательного демо
Предложите составить небольшую проверочную выборку вместе с экспертом предметной области. В неё должны попасть обычные вопросы, неоднозначные формулировки, запросы без ответа в документах, устаревшие версии и ограничения доступа. Размер и пороги приёмки зависят от риска и задачи; единого числа «достаточных вопросов» нет.
Разделите хотя бы два результата: нашёлся ли подходящий источник и получился ли допустимый ответ. Иначе высокая общая оценка может скрыть слабый поиск. Автоматические оценки полезны для сравнения изменений, но их тоже нужно сверять с человеческой проверкой.
Если помощник выполняет действия через API, добавьте ещё один разбор: запрос завершился по таймауту, результат неизвестен. Можно ли повторить вызов без дубля? Кто подтверждает необратимое действие? Как выяснить, что произошло? Опыт только с ответами по документам не доказывает опыт таких интеграций.
Что должно остаться после работы
До подключения специалиста согласуйте не только код. Для этого сценария полезны схема источников и прав, порядок обновления документов, проверочная выборка, описание запуска и список известных ограничений. Нужен человек в вашей команде, который сможет принять эту работу и поддержать её дальше.
В аутстаффинге задачи и приёмку ведёт ваша команда. Если нужен поставщик, который отвечает за обследование, состав команды и внедрение целиком, это уже другой предмет договора. Его лучше назвать прямо до сравнения ставок.
Где потребуется другой профиль
Если трудности связаны с доставкой и качеством источников, нужен опыт инженера данных. Когда приложение готово, но выпуск и восстановление остаются ручными, стоит проверить профиль MLOps-инженера. Серверные интеграции могут потребовать Python-разработчика. Один человек способен совмещать обязанности, однако это выясняется по выполненной работе, а не по приставке AI.
Для сравнения ролей есть отдельный разбор состава ИИ-команды. Если профиль уже понятен, отправьте задачу на подбор AI/LLM-разработчика: что есть сейчас, чего не хватает и кто будет принимать результат. Эти сведения дадут для подбора больше, чем длинный список всех популярных фреймворков.