
Статья
Кого подключить к ИИ-проекту: ML, LLM, Data Engineer или MLOps
Разбираем роли по работе, которую нужно сделать: исследование модели, данные, LLM-приложение и эксплуатация. С примерами задач и вопросами для брифа.
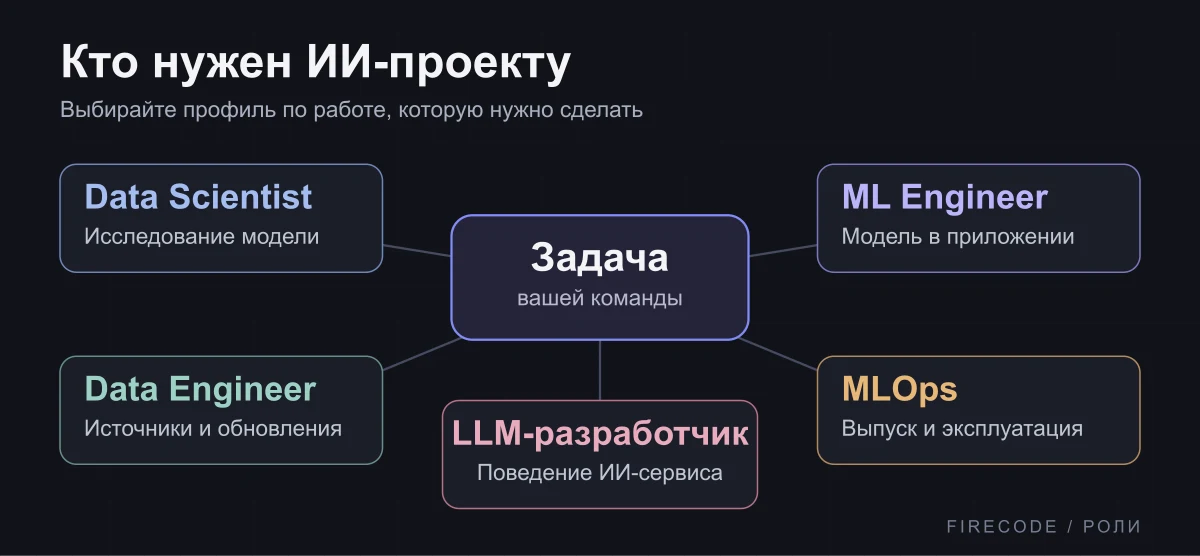
Data Scientist исследует модель, ML Engineer встраивает её в приложение, LLM-разработчик собирает поведение ИИ-сервиса. Data Engineer отвечает за источники, MLOps за выпуск и эксплуатацию. Состав команды зависит от задачи.
Открыть схему в полном размереДопустим, в заявке написано «нужен AI-инженер». На встрече выясняется, что модель уже выбрана, но документы приходят из трёх систем, ответы некому проверять, а выпуск в рабочую среду пока ручной. Здесь можно искать одного человека с очень длинным резюме. Полезнее сначала разделить работу.
Для ИИ-проекта роли стоит выбирать по тому, что нужно изменить в системе. Для исследования модели обычно нужен Data Scientist или ML Engineer, для доставки данных нужен Data Engineer. Приложение на языковой модели собирает LLM-разработчик, а выпуском и эксплуатацией занимается MLOps. Это рабочие ориентиры: названия должностей у компаний различаются, а обязанности приходится согласовывать отдельно.
Начните с задачи, которую можно проверить
«Внедрить ИИ» недостаточно для подбора. Запишите, кто будет пользоваться результатом и какое действие станет доступно. Например: сотрудник задаёт вопрос по внутреннему регламенту, получает ответ со ссылкой на действующую редакцию и открывает исходный документ. Затем уточните детали: что делать при отсутствии ответа, кто видит закрытые документы и кто исправляет ошибку.
Это условный пример, не описание клиентского проекта. В нём уже видны несколько задач: получение документов, поиск подходящих фрагментов, формирование ответа, проверка прав и работа сервиса после запуска. Один специалист может закрыть часть из них. Ответственного за каждую всё равно нужно назвать.
Кому какую работу отдавать
Data Scientist: проверить, решается ли задача на имеющихся данных
Эта роль нужна, когда предстоит исследование: какие признаки доступны, с чем сравнивать результат, как избежать утечки между обучением и проверкой, оправдано ли вообще машинное обучение. Полезным результатом будет воспроизводимый эксперимент с описанием выборки, метрик и ограничений. Хорошее качество на одной тестовой выборке ещё не означает готовность к эксплуатации.
Если задача уже свелась к подключению готовой языковой модели к API и документам, глубокое исследование может не быть первым узким местом. Профиль Data Scientist стоит выбирать под исследовательскую работу, а не ради самого названия.
ML Engineer: превратить решение с моделью в работающий компонент
ML Engineer обычно ближе к реализации: код подготовки признаков и работы модели, интеграция с приложением, тесты, требования к задержке и ресурсам. В небольшой команде он может участвовать и в экспериментах, и в выпуске. На интервью важно выяснить, что именно человек делал сам и кто поддерживал результат после него.
В резюме полезно искать не только семейства моделей. Попросите показать логику решения: исходная задача, ограничения, выбранный подход, проверка и компромиссы. Опыт обучения рекомендательной модели и опыт корпоративного поиска на LLM могут почти не пересекаться.
LLM-разработчик: собрать поведение приложения вокруг языковой модели
Здесь работа включает обращения к модели, поиск контекста, интеграции, обработку ошибок и проверку ответов. Для RAG система находит внешние данные к запросу и передаёт их модели как контекст. Само наличие такого поиска не подтверждает, что найденный документ актуален, доступен пользователю или достаточен для ответа.
Механика retrieval описана в документации LangChain. При подборе специалиста важнее разобраться в этой цепочке, чем требовать конкретный фреймворк. Подробный сценарий интервью есть в статье о выборе LLM/RAG-разработчика.
Data Engineer: обеспечить данные, которым можно доверять
Инженер данных нужен, когда источники надо подключать, обновлять и проверять. В примере с регламентами он получает новые редакции, учитывает удаление документов, хранит необходимые признаки доступа и замечает остановку загрузки. Ошибка в этой части может выглядеть как плохой ответ модели, хотя модель получила старый или неполный контекст.
У Data Engineer спрашивайте о свежести, полноте, повторном запуске и восстановлении загрузки. Перенос данных в векторное хранилище сам по себе не закрывает эти вопросы.
MLOps: выпускать изменения и разбираться в работе сервиса
Когда развёртывание держится на ручных командах автора, а после изменения модели непонятно, что стало хуже, появляется отдельная работа по эксплуатации. MLOps связывает версии кода, артефактов и конфигурации, помогает настроить выпуск, наблюдение и откат.
В LLM-проектах к этому добавляются версии промптов и индекса, трассировка обращений и затраты на вызовы. Такую специализацию часто называют LLMOps. Это не требование завести ещё одну должность: сначала оцените, справляются ли разработчик и платформенная команда. Задачи и границы подключения разобраны на странице MLOps-инженеров.
Когда достаточно одного специалиста
Если в команде уже есть backend, инженер данных, тестирование и человек, отвечающий за эксплуатацию, для ограниченного LLM-сценария может хватить одного разработчика с нужным опытом. У него должны быть понятные входные данные, доступные API и согласованный способ проверки результата.
Если нет ни подготовленных источников, ни приложения, ни процесса выпуска, объём работы будет другим. Тогда требования «сделать всё одному» скрывают разные виды работы. Их можно выполнять последовательно, но загрузка и срок будут зависеть от этого выбора. Для параллельной работы разумно обсуждать команду с распределёнными ролями.
Не забудьте про людей, чьей должности нет в AI-стеке: владельца бизнес-процесса, эксперта по документам, QA и ответственного за доступ к данным. Техническая команда не сможет самостоятельно решить, какой ответ допустим для вашего пользователя.
Что отправить поставщику вместо списка технологий
- Один рабочий сценарий и состояние системы: идея, прототип или действующий сервис.
- Доступные источники и API, правила доступа и ограничения на внешние сервисы.
- Текущий состав команды и задачи, за которые уже кто-то отвечает.
- Ожидаемый результат первого этапа и способ его проверки.
- Нужную загрузку, период участия и требования к передаче знаний.
Ставку имеет смысл сравнивать после этого описания: одинаковое название роли может скрывать разную самостоятельность и объём ответственности. В расходы ИИ-сервиса также входят инфраструктура и обращения к моделям; часы инженера составляют отдельную часть бюджета.
Если нужно усилить существующую команду, опишите задачи для AI/ML-специалиста. На первом обсуждении достаточно схемы процесса без секретов и пользовательских данных. Так проще определить профиль, который действительно закроет недостающую работу.